Clusterward
Logs & Monitoring

Kubernetes Monitoring ohne eigenen Monitoring-Stack

Wenn etwas hakt, wollen Sie drei Dinge sehen: was die Anwendung gerade schreibt, wie sie ausgelastet war und ob sie von außen erreichbar ist. Clusterward zeigt alles an jedem Service – Logs aller Instanzen, CPU und Speicher über 30 Tage und Uptime-Checks mit Alarm. Ohne Agent im Cluster und ohne Grafana-Setup.

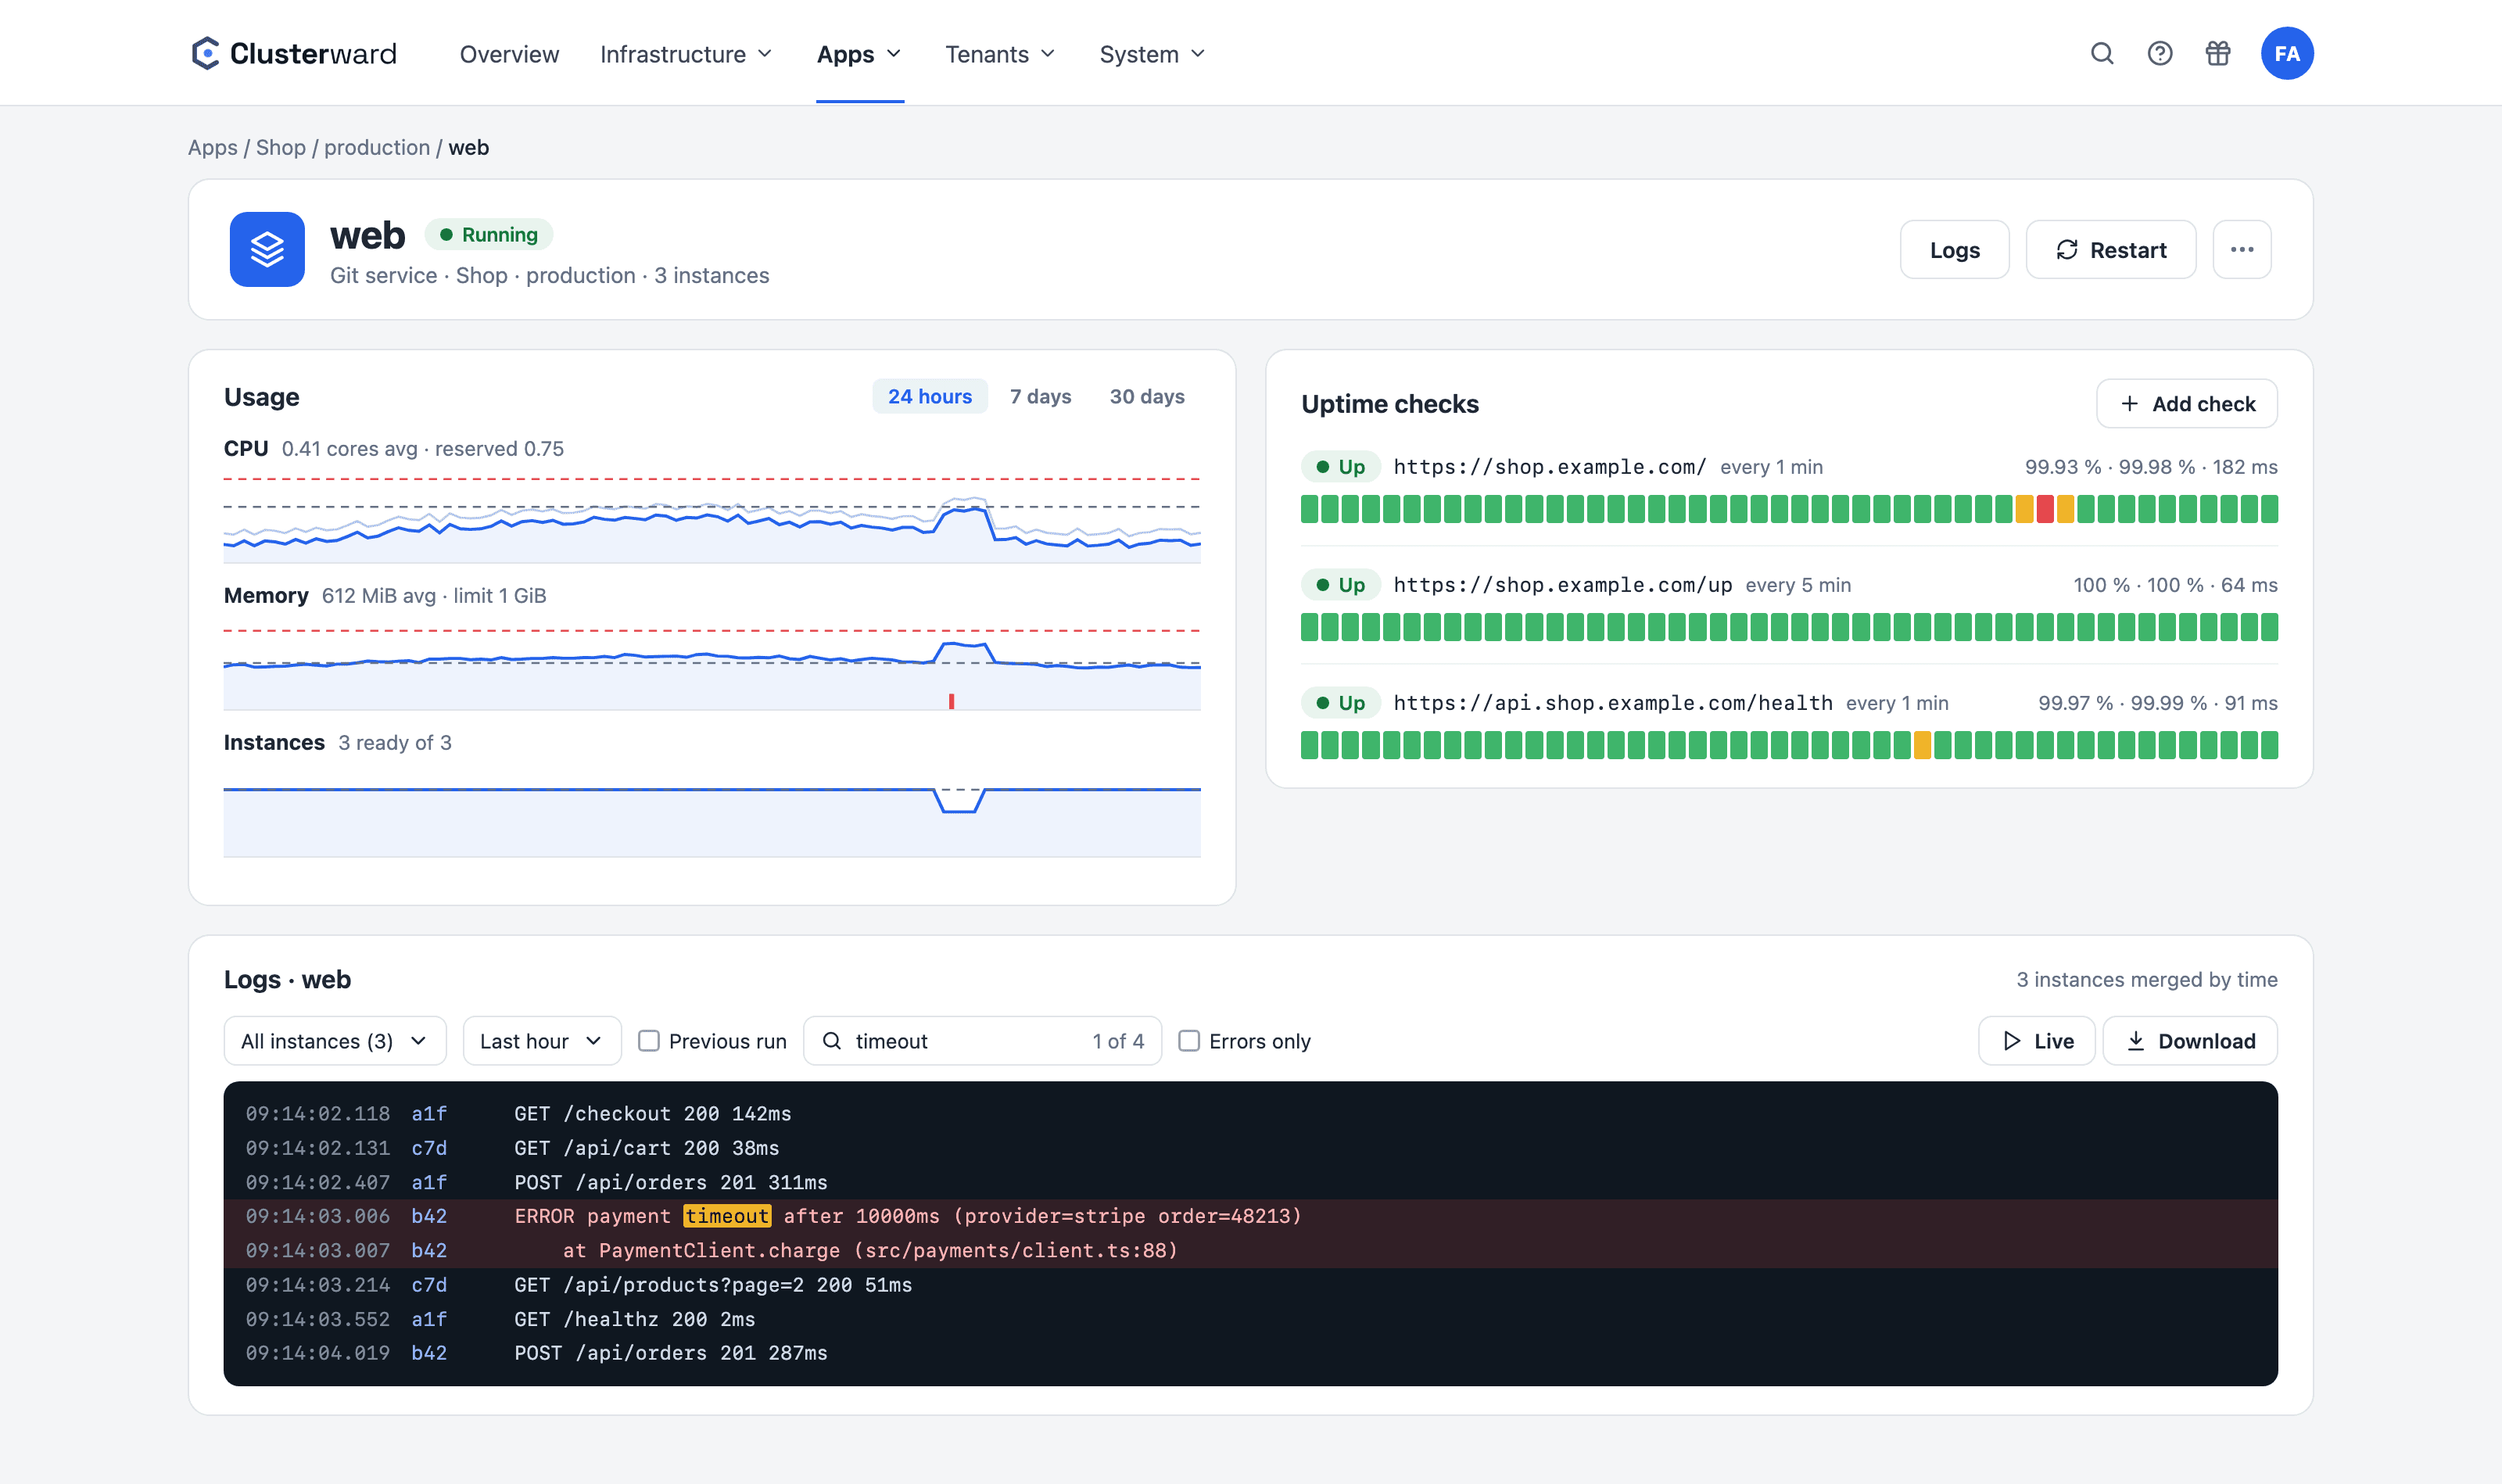
Logs, Auslastung und Uptime-Checks eines Services im Clusterward-Cockpit
Logs aller Instanzen, Auslastung und Uptime-Checks eines Services im Clusterward-Cockpit
Illustration: vereinfachte Darstellung. In der Anwendung sehen Sie mehr Details und Optionen.
Kurz erklärt

Was Monitoring in Clusterward heißt

Kubernetes Monitoring in Clusterward besteht aus drei Teilen am Service: einem Log-Viewer, der die Ausgaben aller Instanzen nach Zeit zusammenführt, einem Auslastungsverlauf für CPU, Speicher und Instanzen, den Clusterward jede Minute selbst aufzeichnet, und Uptime-Checks, die Ihre Domains von außen prüfen. Fällt etwas aus, melden sich Benachrichtigungen – und der Link führt direkt zu den Logs.

Auf einen Blick

Logs
Alle Instanzen zusammen, bis 10.000 Zeilen, live oder als Download
Absturz
Logs des vorherigen Laufs eines abgestürzten Containers
Auslastung
CPU, Speicher, Instanzen von 15 Minuten bis 30 Tage, in Prozent des Limits
Uptime
Bis zu 10 Checks pro Service, jede Minute bis alle 15 Minuten
Alarm
Seite nicht erreichbar und wieder da, per Slack, Teams, Webhook, E-Mail
Einrichtung
Kein Agent im Cluster, nichts zu installieren
So läuft es ab

Vom Alarm zur Ursache

  1. 01

    Merken

    Ein Uptime-Check schlägt zweimal fehl oder ein Deployment scheitert – die Nachricht geht an Ihre Kanäle.

  2. 02

    Öffnen

    Ein Klick in der Aktivitätsanzeige öffnet die Logs, bei einem Absturz direkt den vorherigen Lauf.

  3. 03

    Eingrenzen

    Suchen, nur Fehler zeigen, Zeitraum wählen, die Auslastung daneben ansehen.

  4. 04

    Beheben

    Speicher erhöhen, neu starten oder eine frühere Version wiederherstellen.

Was drin ist

Was Logs & Monitoring abdecken

Das, was Sie bei einer Störung zuerst brauchen, an dem Service, um den es geht.

Logs aller Instanzen

Die Ausgaben aller Instanzen eines Services, nach Zeit zusammengeführt, mit Markierung, von welcher Instanz jede Zeile stammt. Oder eine Instanz allein.

Zeiträume und Live

Die letzten 500 Zeilen, 15 Minuten, eine Stunde, 6 oder 24 Stunden – bis 10.000 Zeilen, flüssig scrollbar. Oder live mitlesen.

Suche und Fehlerfilter

Treffer werden markiert, Sie springen von einem zum nächsten. „Errors only“ blendet alles andere aus.

Vorheriger Lauf

Ist ein Container abgestürzt und neu gestartet, zeigt Clusterward die Logs des abgestürzten Laufs – dort steht meist die Ursache.

Auslastung über 30 Tage

CPU und Speicher in Prozent des Limits, dazu die Instanzen, jede Minute aufgezeichnet, von 15 Minuten bis 30 Tage. Reservierung als Linie, Neustarts als Markierung, ein Klick öffnet das Diagramm groß mit aktuellem, mittlerem und Spitzenwert – auch für Helm-Services.

Uptime-Checks

Prüft eine Domain des Services per HTTPS, mit Pfad und erwartetem Status. Verfügbarkeit über 24 Stunden und 7 Tage, dazu die mittlere Antwortzeit.

Alarm bei Ausfall

Zwei Fehlschläge in Folge melden die Seite als nicht erreichbar, der erste Erfolg danach als wieder da. Einmal pro Ereignis, nicht als Flut.

Download als Datei

Der gewählte Zeitraum als .log-Datei, zum Weitergeben an Entwickler oder Support.

Status im Kopf

Ein ausgefallener Check steht in der Aktivitätsanzeige des Cockpits, bis er wieder antwortet.

Standards statt Eigenbau

Direkt aus Kubernetes, ohne Agent

  • Kubernetes-Log-API

    Logs kommen direkt von den Pods über die Kubernetes-API – nichts wird im Cluster installiert.

  • metrics-server

    CPU und Speicher liefert der metrics-server des Clusters; ohne ihn zeichnet Clusterward die Instanzen auf.

  • HTTPS-Prüfung

    Checks senden einen GET über HTTPS, folgen keinen Weiterleitungen und werten Zertifikatsfehler als Ausfall.

  • Ihre Kanäle

    Alarme laufen über die Benachrichtigungen: Slack, Teams, Webhook oder E-Mail.

Was sich ändert

Monitoring mit und ohne Clusterward

Fakten

Was wie lange sichtbar ist

Clusterward speichert Auslastung und Check-Ergebnisse selbst; Logs liest es live aus dem Cluster.

DatenAuflösungWie lange
LogsJede ZeileSo lange der Pod lebt (letzter und vorheriger Lauf)
Auslastung, 24 StundenPro Minute24 Stunden
Auslastung, 7 TagePro 10 Minuten7 Tage
Auslastung, 30 TagePro Stunde30 Tage
Uptime-ErgebnisseJede Prüfung7 Tage
BenachrichtigungenJede Nachricht30 Tage im Zustellprotokoll
Weiterführend

Monitoring im Zusammenspiel

Wohin Alarme gehen und welche Ereignisse sich melden, stellen Sie unter Benachrichtigungen ein. Wie ein gescheitertes Rollout erkannt wird und wie Sie zu einer früheren Version zurückkehren, steht unter Deployments.

Was die Übersicht für die technische Leitung bedeutet, beschreibt Für CTOs; welche Nachweise die Protokolle für ein Audit liefern, Audit & NIS2.

Was kubectl kann, wo es aufhört und wann sich ein eigener Stack lohnt, beschreibt Logs, Auslastung und Uptime ohne eigenen Monitoring-Stack; wie Sie nach einem fehlerhaften Release zurückkommen, Rollback auf Kubernetes: Warum ein Tag keine Version ist.

Verwandte Seiten

Was dazu gehört

Deployments

Git, Container-Image oder Helm-Chart – mit Health-Check ausgerollt.

Zu Deployments

Für CTOs

Planbare Kosten, kein Kopfmonopol, kein Lock-in.

Zu Für CTOs
FAQ

Häufige Fragen zu Logs & Monitoring

  • Nein. Logs liest Clusterward über die Kubernetes-API, die Auslastung über den metrics-server des Clusters, und die Uptime-Checks laufen von Clusterward aus. Ohne metrics-server zeichnet Clusterward nur die Zahl der Instanzen auf.

Ihre Frage ist nicht dabei? Schreiben Sie uns, wir antworten in der Regel am selben Werktag.

Frage stellen

Logs und Monitoring in der Demo

Wir lassen einen Service abstürzen, finden die Ursache im vorherigen Lauf und richten einen Uptime-Check mit Alarm in Ihrem Slack ein.